지난 글에서 기획자와 PM이 바이브 코딩에 특히 유리하다고 작성했습니다.

요구사항 정의
스코프 관리
리뷰와 피드백

본체가 되는 능력을 이미 갖고 있으니까요.


그런데 한 가지를 짚고 넘어가야 합니다.

여러분이 가장 자신 있는 기술인 기획서 작성은 AI 앞에서 습관 하나를 바꿔야 합니다.


개발자는 되묻고, AI는 채운다

기획서를 개발자에게 넘겼을 때를 떠올려보세요.

문서에 빈칸이 있으면 어떻게 되던가요.

"파일 용량 제한은 없나요?"
"이름 겹치면 덮어써요, 아니면 막아요?"
"실패하면 유저한테 뭐라고 보여줘요?"

질문이 돌아옵니다. 귀찮았겠지만, 그 질문들이 사실 안전망이었습니다.

여러분의 빈칸을 사람이 막아주고 있었던 것입니다.

십수 년 일하며 우리가 "기획서는 어차피 대화로 완성된다"고 배운 이유죠.


AI는 다릅니다.

AI는 되묻는 대신 홀로 채웁니다.

빈칸을 만나면 멈추지 않고, 가장 그럴듯한 값으로 메꿔서 완성된 결과물을 가져옵니다.


문제는 그 "그럴듯한 값"이 여러분의 의도가 아니라 확률이라는 것입니다.

그리고 결과물이 워낙 매끈해서, 뭐가 채워졌는지 티가 안 난다는 것은 부가적으로 따라오는 이슈입니다.


빈칸이 질문으로 돌아오면 사고를 막을 수 있습니다.

반대로 빈칸이 소리 없이 채워지면, 사고가 나도 사고인 줄 모릅니다.
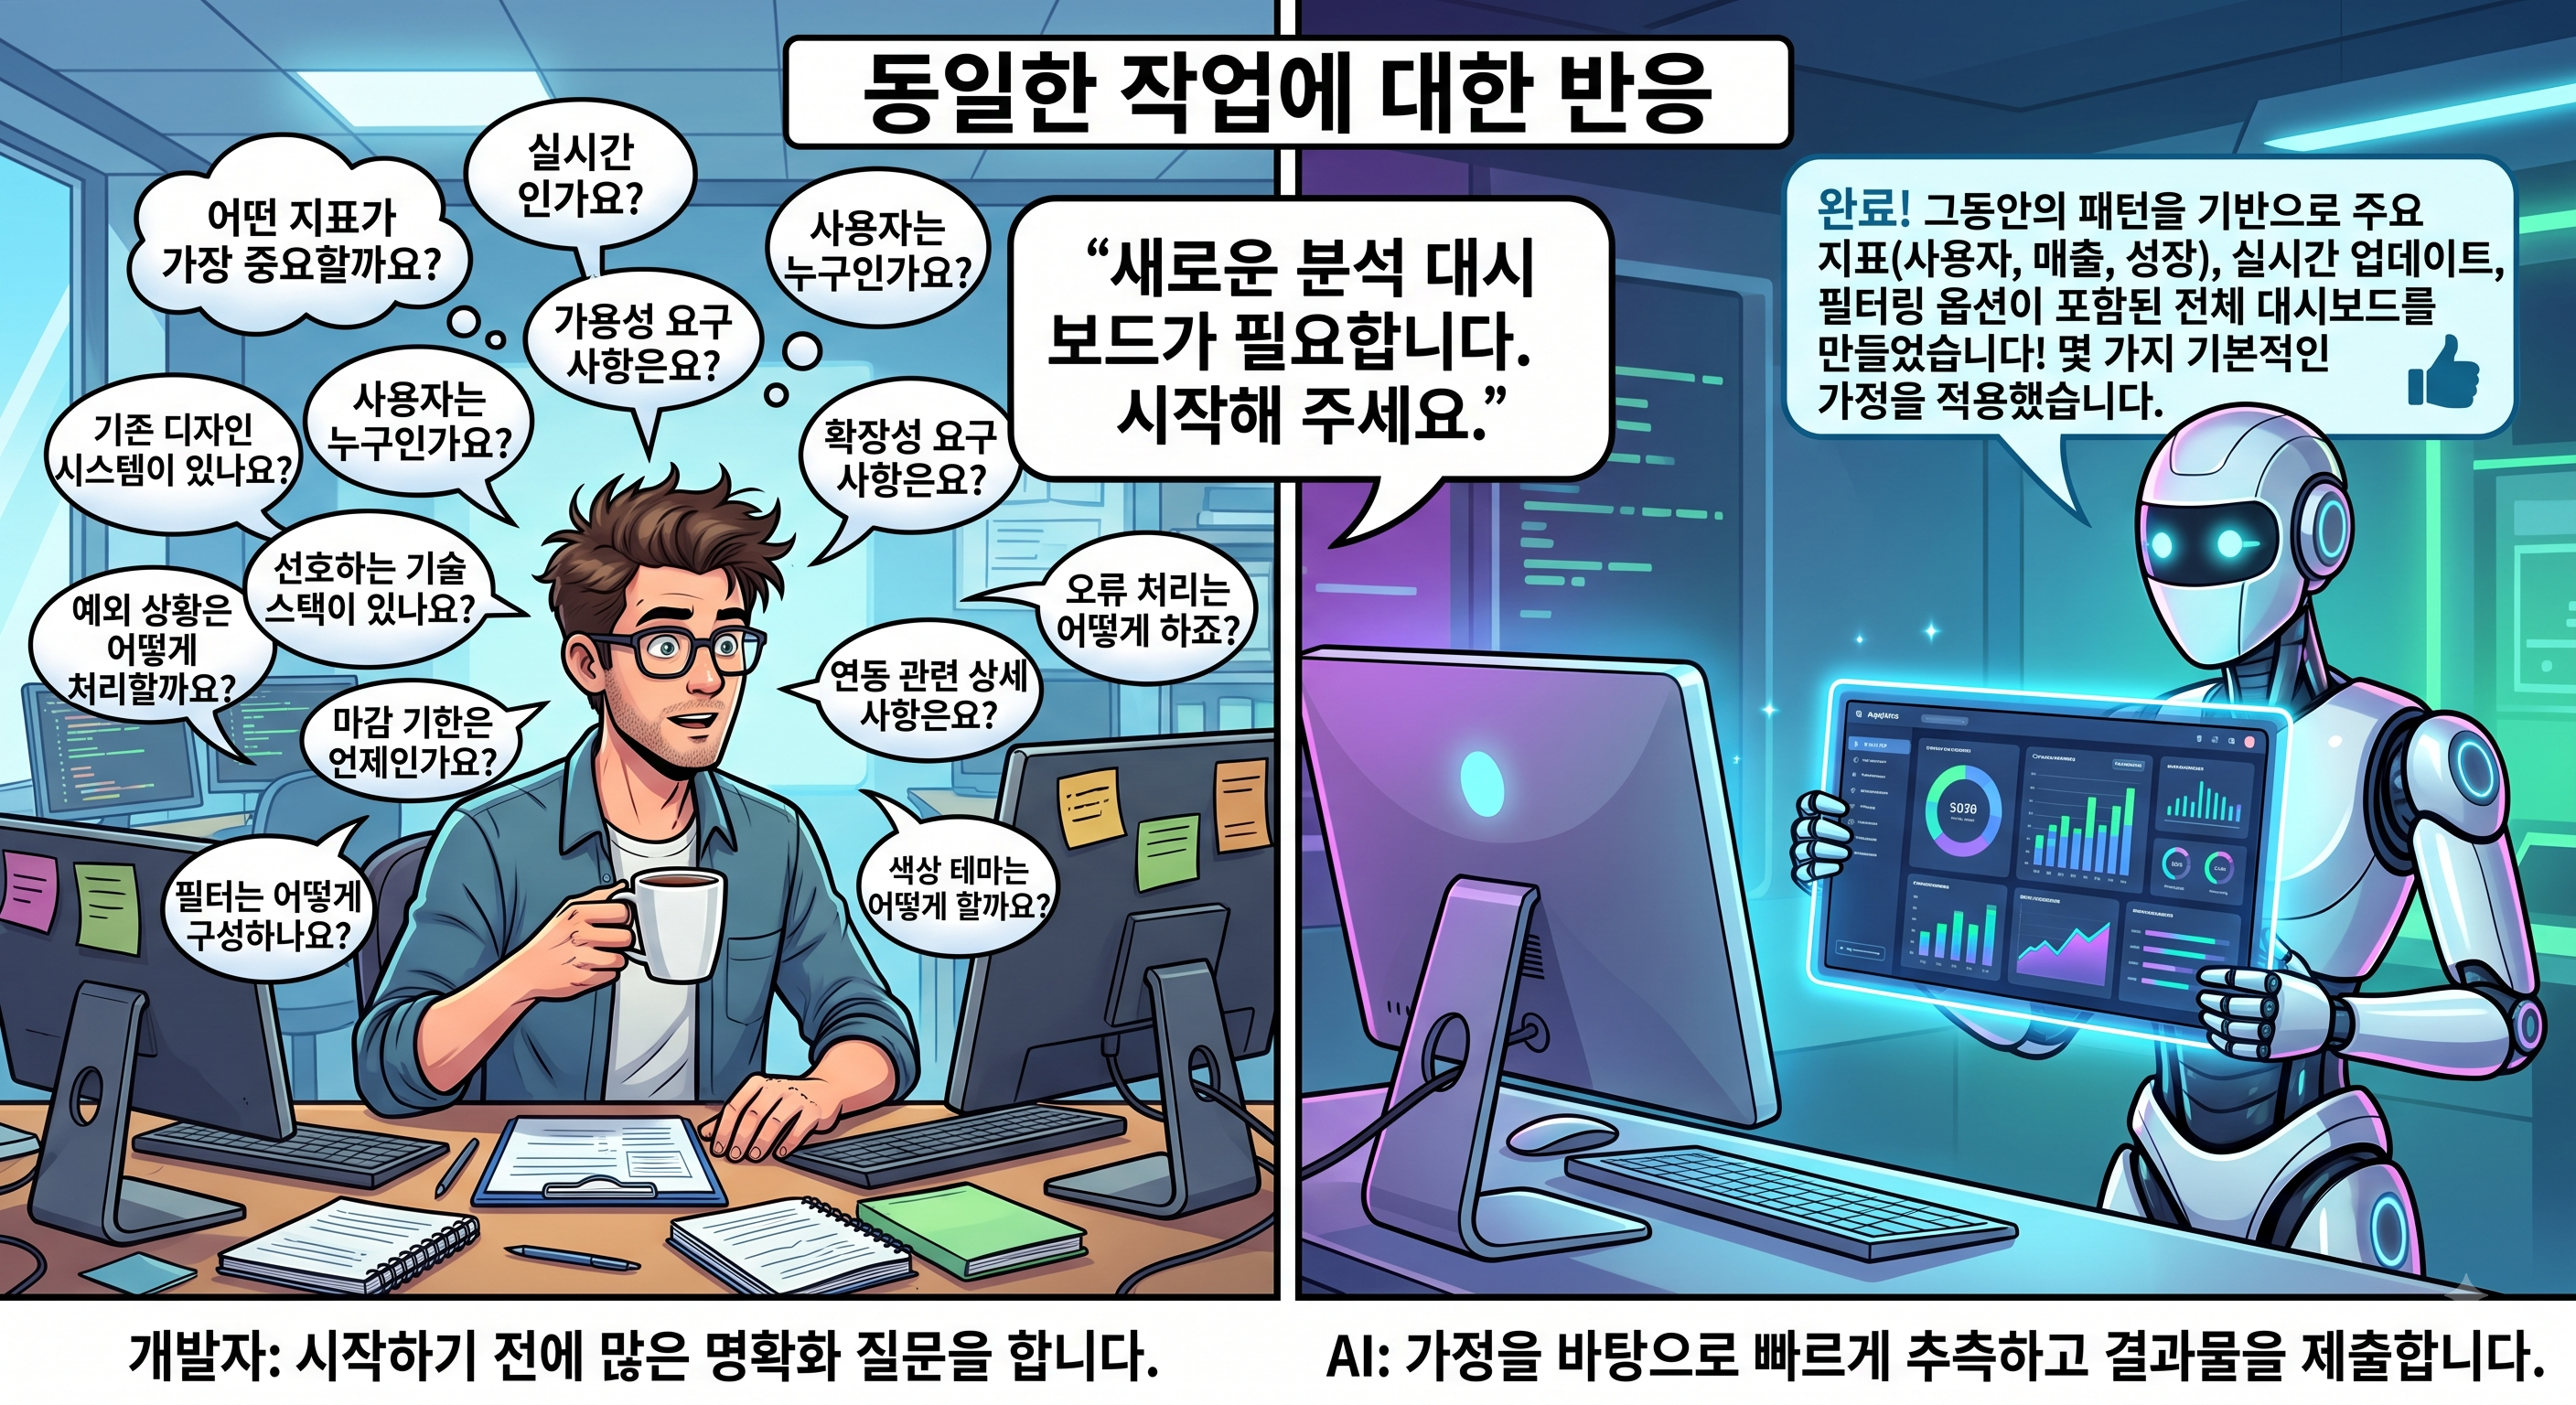
동일한 작업에 대한 개발자와 AI의 차이


실제로 겪은 일

강의를 만들면서 AI에게 파일 업로드 기능을 시킨 적이 있습니다.

요구사항을 꽤 자세히 적었다고 생각했습니다.

드래그 앤 드롭으로 올리고,

지원 안 하는 확장자는 거르고,

용량 제한도 걸고.


AI는 깔끔하게 만들어왔습니다.

화면도 예뻤고,

거부 처리도 잘 됐습니다.

그런데 작업 브리핑을 읽다가 한 문장이 걸렸습니다

"이 단계는 서버 왕복 없이 전부 클라이언트 안에서 처리됩니다."

풀어 쓰면 업로드한 파일을 브라우저가 들고만 있고, 어디에도 저장하지 않는다는 뜻이었습니다.


제 기획서에 "파일을 어디에 저장한다"가 없었던 겁니다.

개발자였다면 "이거 저장은 어디로 가요?"라고 물었을 빈칸을

AI는 "일단 안 저장하는 걸로" 채워서 완성해온 것입니다.

겉보기엔 멀쩡히 동작하는 화면과 함께 말입니다.


빈칸은 제 것이었습니다. AI는 시킨 대로 시킨 만큼만 했습니다.


그래서 기획 습관을 이렇게 바꿉니다

이 차이를 알고 나면 고칠 것은 하나입니다.

사람에게 넘길 때는 넘어갔던 것을 AI에게 넘길 때는 기획 단계에서 꼼꼼하게 닫아야 합니다.


제가 AI를 사용하는 방법은 거창하지 않습니다.

작업서를 전달하기 전에 한번 더 검토할 뿐입니다.


"실패하면?"

이 기능이 안 됐을 때 어떻게 할지. (AI 호출이 실패하면? 파일이 너무 크면?)

"중복되면?"

같은 처리를 두 번 하면 어떻게 할지. (같은 이름의 파일이 또 올라오면?)

"끝나면?"

이 기능이 "됐다"의 기준을 적었나. (파일 10개를 올리면 목록에 뜬다)

특히 마지막 질문은 있느냐 없느냐가 검수 가능 여부를 가릅니다.


이건 새로운 기술이 아닙니다.

시니어 기획자들이 주니어 기획서를 리뷰할 때 하는 바로 그 질문들이에요.

예외 처리, 엣지 케이스, 완료 조건. 여러분이 이미 아는 개념입니다.


달라진 것은 하나입니다.

이 질문을 대신 해주던 개발자가 이제 없다는 것.

그 역할이 여러분 안으로 들어와야 합니다.


그리고 한 가지 더. 다 못 닫아도 괜찮습니다.

저도 저장 위치를 놓쳤으니까요.

대신 결과물을 받으면 검토 단계에서 "내가 안 적은 걸 얘가 뭘로 채웠지?"를 찾습니다.


빈칸을 미리 다 막는 게 아니라,

뭘로 채워졌는지 추적 가능한 상태를 유지하는 겁니다.

그게 안 되는 순간부터가 진짜 사고입니다.


정리

  • 개발자는 기획서의 빈칸을 질문으로 돌려주고, AI는 그럴듯한 것으로 채워서 돌려줍니다.
  • 그래서 AI에게 넘기는 기획서는 "실패하면 / 중복되면 / 끝나면" 세 질문을 스스로 통과해야 합니다.
  • 이건 새 기술이 아니라, 여러분이 리뷰 때 이미 쓰던 질문의 방향을 자기 문서로 돌리는 일입니다.

지난 글의 결론에 한 줄을 보태며 마칩니다.

기획자와 PM은 바이브 코딩의 적임자가 맞습니다.

되물어주는 사람이 사라진 자리에서, 스스로 되묻는 습관까지 갖추면 말입니다.

바이브 코딩 이야기가
나올 때마다 반복되는 문구가 있습니다.
"이제 누구나 만들 수 있다."


저는 이 말이 반만 맞다고 생각합니다. 그리고 반만 맞는 말은 아무도 움직이지 못합니다.

"누구나"는 곧 "내가 어떻게 하는데?"로 읽히니까요.

14년간 개발자로 지내오며 기획자, PM, 아티스트와 일해온 사람으로서, 더 정확한 문장을 제안하고 싶습니다.

"누구나"가 아니라, 기획자와 PM이 특히 잘할 수밖에 없습니다. 개발자보다 유리한 지점이 있습니다.


AI에게 일 시키기 = 여러분이 매일 하는 일

AI로 뭔가를 만드는 과정을 뜯어보면 이렇게 됩니다.

뭘 만들지 정의하고,

범위를 자르고,

나온 결과물을 검토해서 다시 시키는 반복.


이걸 실무자의 언어로 다시 쓰면:

요구사항 정의
스코프 관리
리뷰와 피드백

여러분이 매일 하는 일입니다.

개발자에게 기획서를 넘기고,

"이번 스프린트엔 여기까지만"을 정하고,

나온 빌드를 보고 "의도랑 다른데요"를 짚어내는 일 말입니다.


바이브 코딩은 이 상대가 개발자에서 AI로 바뀐 것뿐입니다.

오히려 AI는 밤에도 일하고, 기분이 상하지 않고, 다시 시켜도 한숨을 쉬지 않죠.


실제로 제가 강의를 만들면서 AI와 주고받은 결정들은 전부 이런 것들이었습니다.

"이 작업 단위가 다른 것들에 비해 너무 뚱뚱하다, 쪼개자."
"이 기능은 이번 범위에서 빼자."
"네가 정리한 계획, 사용자 흐름이 통째로 빠져 있는데?"

코딩 지식으로 내린 결정이 하나도 없습니다.

전부 기획 판단입니다.

그리고 이 판단이 결과물의 품질을 갈랐습니다.

코딩이요? 코딩은 AI가 합니다. 그게 바이브 코딩의 정의입니다.


그런데 왜 다들 막히는가

여기까지 읽으면 반문이 나올 겁니다.

"그렇게 쉬우면 왜 내 주변 사람들은 다 하다가 포기했는데?"

제가 비개발 직군 지인들을 관찰하며 확인한 병목은 두 개였습니다.

그리고 둘 다 능력의 문제가 아니었습니다.


먼저 말씀드릴 것은 도구입니다.

바이브 코딩 자료 대부분이 검은 터미널 화면과 마크다운 문서에서 시작합니다.

내용을 배우기 전에 도구에서 이탈하는 거죠. 그런데 이건 우회로가 있습니다.

저는 거의 모든 작업을 노션과 클로드 데스크톱 안에서 진행합니다.

이미 쓰고 있는 도구 두 개만으로도 전체 사이클이 돌아갑니다.

도구 문제는 사실 문제가 아니었던 겁니다.


다음 병목이 진짜입니다. "키워드"


아는 단어만큼만 시킬 수 있다

두 사람이 같은 화면을 만들려고 합니다.

파일을 끌어오면 화면 전체가 살짝 어두워지면서 "여기 놓으세요"가 뜨는,

요즘 흔한 그 업로드 화면이요.


A는 이렇게 시킵니다.

"파일을 끌고 오면 화면이 어두워지고 아무 데나 놓아도 올라가게 해줘."


B는 이렇게 시킵니다.

"창 전체를 드롭존으로 하고, 드래그 진입 시 딤드 처리해줘."


둘 다 같은 걸 원했지만,

결과물의 정확도는 다르게 나옵니다.

B가 코딩을 더 잘해서가 아닙니다.


드롭존과 딤드


그 화면을 부르는 단어를 사용했을 뿐입니다.

AI에게 일을 시킬 때의 냉정한 규칙은 아는 단어만큼만 시킬 수 있다는 것입니다.


머릿속 그림이 아무리 선명해도, 그걸 입력하는 명칭을 모르면 AI와 나 사이에서 뭉개집니다.

반대로 명칭을 정확히 입력하는 순간, AI는 놀랄 만큼 정확해집니다.

이게 기획자와 PM에게 남은 마지막 한 조각입니다.

능력이 아니라 키워드입니다.

키워드는 학습이 아니라 온보딩이다

"결국 뭘 배우긴 해야 하네"라고 느끼실 수 있는데 정확히 말씀드리고 싶습니다.

개발을 배우는 것이 아닙니다.

문법도, 자료구조도 없습니다.

필요한 건 단어 수십 개입니다.


드롭존, 딤드, LNB 같은 쉬운 것들부터

포트, 라우터 같은 기술적인 부분들까지


여러분들이 이미 경험해본 일입니다.

게임 개발을 처음 마주쳤을 때 밸런싱, 빌드, QA라는 단어를 익혔고,

이직할 때마다도 그 팀의 용어를 익혔을 것입니다.


새 직무를 배운 게 아니라 새 팀에 온보딩한 거죠.

개발 키워드도 정확히 그 급의 과제입니다.

낯선 직무가 아니라 낯선 팀.

그리고 여러분은 온보딩을 십수 번 해본 사람들입니다.


모르는 키워드가 나오면 어떻게 하냐고요?

그 자리에서 AI에게 물으면 됩니다.

실제로 저는 강의를 만들다가 학생분들이 모를 것 같은 용어가 나와 작업을 멈추고 클로드에게 물었습니다.

"이게 뭐야? 비개발자도 알아듣게 설명해줘."


설명을 확인하고, 내가 아는 것에 대입해 본 다음, 그 다음에 결정합니다.

키워드 사전을 외우고 시작하는 게 아니라, 현장에서 한 개씩 채우면서 갑니다.

온보딩이란 원래 그렇게 하는 거니까요.


정리

  • 바이브 코딩의 본체는 요구사항 정의, 스코프 관리, 검토와 피드백입니다. 이것은 기획자와 PM이 이미 가진 능력입니다.
  • 코딩은 AI가 합니다.
  • 남은 건 키워드 수십 개이고, 그건 새 직무 학습이 아니라 새 팀 온보딩 수준의 과제입니다.

그래서 "누구나 할 수 있다"는 말을 이렇게 고쳐 쓰고 싶습니다.

여러분이 특히 잘할 일인데, 아직 그 팀의 단어를 못 배웠을 뿐이라고요.

모델은 커모디티가 된다.
마진은 판단에 남는다.


2025년 2월, OpenAI는 당시 가장 비싼 모델 GPT-4.5를 출시했습니다. 백만 토큰당 입력 75 달러, 출력 150 달러. 그리고 다섯 달이 지나기 전, API에서 제거됐습니다. 상업 수명 4.5개월, OpenAI 역사상 최단명 모델입니다. 이 위에 제품을 지었던 개발자들은 그대로 마이그레이션 사이클에 갇혔습니다.


시장이 이 이야기에서 꺼낸 교훈은 명확했습니다. "남의 모델 위에 사업을 짓지 마라. 가치는 모델 소유자에게 남는다." 저는 이 교훈이 절반만 맞다고 봅니다. 정확히 어느 절반이 맞는지가 오늘 글의 주제입니다.

AI Migration Treadmill


1. 가치는 위로 밀려 올라간다 (Value Migration)

인풋이 커모디티가 되면,
차별화는 위층으로 밀려난다


AI 밸류체인은 세 층입니다. 인프라(GPU, 클라우드), 모델(파운데이션), 콘텐츠/애플리케이션. 인프라는 이미 소수 승자로 굳었고, 지금 움직이는 것은 모델 층입니다.


2026년 6월 기준으로 SWE-bench Verified에서 모델 5개가 0.4점 이내에 몰려 있는데 가격은 5배 차이가 납니다. 시장 전체로 넓히면 최저가 토큰과 프리미엄 추론 토큰의 격차는 600배가 넘습니다. 가격이 더 이상 성능의 대리 지표가 아니라는 뜻입니다. 오픈웨이트와 폐쇄형 프론티어의 격차는 공개 벤치마크 기준 평균 4개월(프라이빗 벤치마크로는 8~10개월, 이 차이는 뒤에서 다시 다루겠습니다.) 수준에서 18개월 넘게 안정적입니다. 격차는 실재합니다. 하지만 좁고, 예측 가능하고, 벌어지지 않습니다.


그리고 파운데이션 모델 훈련은 컴퓨트, 데이터, 인재의 자본전쟁입니다. 하이퍼스케일러가 아닌 모든 주체에게 경쟁 가능한 층은 그 위밖에 없습니다. AI Content가 중요하다는 저의 생각은 낙관이 아니라 소거법의 결론입니다.


2. "그래서 AI Content는 어렵다" (The Bear Case)

반대 서사는 정직하게,
최대 강도로


빅테크와 VC가 애플리케이션 층을 취약하다고 보는 근거는 넷입니다.


첫째, 가격 변동. Claude 3.5 Haiku는 출시 직전까지 가격 유지를 시사했다가 4배 인상됐고(공식 사유: 지능 상승을 반영), 반발이 커지자 한 달 만에 부분 철회됐습니다. 방향이 문제가 아닙니다. o3는 하루아침에 80% 인하됐는데, 경쟁자의 원가가 1/5이 되는 것도 유닛 이코노믹스 파괴입니다. 정가가 조용해도 안심할 순 없습니다. 신형 토크나이저가 같은 텍스트에서 최대 35% 더 많은 토큰을 만들어내면, 정가표는 그대로인데 청구 비용이 올라갑니다. 문제는 인상이냐 인하냐가 아니라 분산입니다.


둘째, 폐기 사이클. 2026년 2월 GPT-4o, 4.1, o4-mini가 약 3개월 예고로 일괄 중단됐습니다. 1년간 다듬은 프롬프트가 새 모델에서 다르게 동작하는 "prompt drift"라는 말까지 생겼죠. 프리뷰 모델은 예고 2주만으로도 은퇴합니다.


셋째, 플랫폼 흡수. 내 래퍼가 하던 기능을 제공사가 자기 제품에 넣어버리는, 이른바 GPT 래퍼의 취약성입니다.


넷째, 규제. 빅테크의 목록에는 없던 항목인데, 올여름 실물로 등장했습니다. 2026년 6월 12일, 출시 사흘 뒤였던 Anthropic의 최상위 공개 모델 Fable 5가 미국 수출통제 지침으로 전 세계 모든 고객에게서 일괄 정지됐고, 지침이 해제된 뒤 7월 1일에야 복구됐습니다. 19일 동안 그 위에 지은 워크플로는 함께 꺼져 있었습니다. 가격과 폐기가 제공사의 선택이라면, 이것은 제공사조차 선택할 수 없는 변수입니다.


이 넷은 특정 조건에서 전부 옳습니다. 그 조건이 무엇인지가 이 글의 나머지입니다.


3. 네 리스크는 하나의 병이다 (The Hidden Premise)

전부 하나의 전제에서 나옵니다.
그것은 남의 호스팅 프론티어에 의존한다는 것입니다.

빅테크가 말하는 리스크 프론티어 API 의존 오픈소스 자체 구동

가격 변동 제공사가 결정, 마진 인질 소거. 비용 = 하드웨어 감가 + 전기료
폐기, 업데이트 버전이 내 밑에서 바뀜 소거. 받은 웨이트는 폐기되지 않음. 업그레이드는 내 일정에, 내 테스트 후에
플랫폼 흡수 제공사가 기능을 삼킴 완화. 흡수당할 플랫폼 자체가 없음
규제 정지 제공사 의사와 무관하게 꺼질 수 있음 소거. 이미 받은 웨이트는 회수 불가. 차기 버전 접근은 별개 문제

비용도 정직하게 추산해 보겠습니다. 소비자 GPU 한 장으로 자체 구동하면(3년 감가상각 + 전기료, 가동률 30% 가정) 백만 토큰당 약 1 달러, 이미 보유한 하드웨어라면 한계비용 약 0.5 달러 수준입니다. 최저가 오픈웨이트 API(0.14 달러/0.28 달러)보다 비쌉니다. 절대 비용으로는 집니다.


자체 구동의 경제성은 평균이 아니라 분산에 있습니다. API 비용에는 가격 변동과 폐기, 재테스트라는 분산이 붙고 로컬에는 붙지 않습니다. 하나 덧붙이면 그 최저가 API는 입력 데이터를 학습용으로 보존합니다. 최저가의 숨은 가격은 당신의 데이터입니다.


4. 같은 진단, 반대 처방 (Scale Asymmetry)

진단은 맞다.
복사하면 틀린다


빅테크 규모에서 프론티어 API에 의존하는 콘텐츠 사업은 진짜로 취약합니다. 빅테크 말이 맞습니다. 하지만 소규모 플레이어가 good-enough 구간에서 오픈소스를 자체 구동하는 사업은 취약성을 만드는 의존성을 애초에 끊었으니 오히려 API 기반보다 견고합니다.


트레이드오프는 하나, 절대 프론티어 성능의 포기입니다. 그런데 오픈소스가 이미 기준선을 넘은 구간에서는 그 비용이 사실상 0입니다.


빅테크의 "AI Content는 어렵다"는 진단은 빅테크 자신의 사업 모델에 대해선 맞습니다. 그 진단을 소규모 스타트업에 그대로 복사하는 순간 틀립니다.


5. 공짜는 아니다 (The Honest Brake)

오픈소스라는 길은 엔지니어링 엄밀성을 특별히 보상한다


일방적 낙관으로 끝내면 거짓말입니다. 브레이크 네 개를 밟고 가겠습니다.

  • 커모디티 인풋은 커모디티 아웃풋을 만듭니다. 접근이 공짜면 아무나 그 위를 만들 수 있습니다. 해자는 AI에 직교하는 곳이고 유통, 독점 데이터, 도메인 통합, 그리고 검증과 판단에서만 나옵니다.
  • good-enough 선은 위로 움직입니다. 그 선에 그냥 주차하면 마진 하락 구간에 주차한 겁니다. 마진은 막 가능해졌지만 경쟁자는 아직 못 따라온 좁은 창을 반복해서 잡는 쪽에 남습니다.
  • 경계는 도메인이 아니라 과제 난이도를 가로지릅니다. 프라이빗 벤치마크를 포함한 NIST 평가에서 최상위 오픈웨이트는 수학 벤치마크에선 프론티어와 사실상 대등했지만, 사이버, 추상추론, 장기 에이전틱 코딩에선 30점 이상 벌어졌습니다. 구조화 추출, 요약, 분류, 나레이션은 왼쪽이고 장기 에이전틱 코딩과 오류가 연쇄되는 과제는 오른쪽입니다.
  • 자체 구동은 공짜가 아닙니다. 운영, 튜닝, 검증 역량을 요구하고 컴플라이언스 책임도 직접 상속합니다(규제 산업이라면 폐쇄형 모델이 옳은 기본값일 수 있습니다). 의존이 사라진 게 아니라 API 제공사에서 내 역량으로 이동한 것뿐입니다. 역량이 있는 사람에게는 해자가 되고 없는 사람에게는 장벽이 됩니다.

마치며: 승부처는 검증과 판단

같은 오픈 모델을 쓰는 두 팀을 상상해 보세요. A팀은 모델 출력을 그대로 내보냅니다. 이것은 데모입니다. B팀은 비결정성을 표현과 문체에만 허용하고, 사실과 수치, 그리고 식별은 검증 계층을 거쳐야 내보냅니다. 이것은 제품입니다. 같은 인풋, 다른 신뢰죠.

AI Content의 승부처는 싼 모델을 신뢰 가능한 제품으로 바꾸는 엔지니어링 판단입니다. 오픈소스는 그 판단을 가진 사람에게 무기가 됩니다.


참고 자료

관련글


맥 로컬 LLM 구축 - Local First AI

GitHub - chessire/shelter-puppyContribute to chessire/shelter-puppy development by creating an account on GitHub.github.comAI는 한 덩어리가 아닙니다.역할이 다른 도구들을,한 대의 맥 위에 포개는 일입니다."유기견 입양에 A

chessire.tistory.com


완벽한 실행자와 불완전한 가설
—
사람의 실수가 사라지지 않는 이유

AI와의 협업


최근 공개되는 AI 데모들을 보면, 개발 업무의 상당 부분이 빠르게 자동화되는 흐름은 부정하기 어렵습니다.

설계 초안 작성부터 구현, 테스트 코드 생성, 문서화까지 그럴듯한 결과가 빠른 속도로 나오고 있습니다.

이 지점에서 자연스럽게 질문이 생깁니다.

AI가 설계부터 구현까지 수행하는 시대에, 사람의 ‘추론 능력’은 어디에서 가치를 가지는가?


이 글은 그 질문에 대해, 감정적 위로가 아니라 정의·구분·한계·실무적 함의 중심으로 정리한 글입니다.


1. 전제: AI의 강점은 생산과 재조합에 있다.

우선 AI의 성과를 축소해서 해석할 이유가 없습니다.

현재의 AI는 아래 영역에서 이미 실무적으로 유의미합니다.

  • 요구사항이 비교적 명확할 때의 코드 생성 및 리팩터링 보조
  • 기존 패턴/라이브러리 사용법의 빠른 검색 및 샘플 구성
  • 문서/테스트/로그 템플릿화, 리뷰 초안 생성
  • 유사한 문제를 빠르게 풀어내는 재조합 속도

이 강점은 기술적으로 보면 자연스럽습니다.

대규모 데이터에서 패턴을 압축하고, 그 패턴을 조건에 맞춰 재배열하는 방식은

특히 In-Distribution(학습 분포와 유사한 조건)에서 높은 성능을 보이기 때문입니다.

여기까지는 논쟁이 아닙니다.

실무자라면 체감하는 영역입니다.


2. 구분: 추론을 한 단어로 뭉치면 오해가 발생한다.

문제는 추론이라는 단어를 하나로 뭉칠 때 생깁니다.
실무에서 추론은 대략 두 층으로 나뉩니다.

  1. 해결(Problem Solving): 주어진 문제를 푸는 능력
  2. 정의(Problem Framing): 무엇이 문제인지 규정하고, 성공 조건과 제약을 설계하는 능력

AI는 1)에서 빠르게 강해지고 있습니다.
반면, 2)는 여전히 사람의 비중이 큽니다.

이유는 간단합니다.

  • 목표가 다중(KPI 충돌)이고, 우선순위가 조직/비즈니스에 의해 결정됨
  • 데이터가 부족하거나, 실험 비용이 커서 정답이 즉시 관측되지 않음
  • 실패 원인이 코드 외부(운영/프로세스/사용자 행동/조직 구조)에 섞여 있음
  • 요구사항 자체가 모순적이거나, 아직 합의되지 않은 상태가 흔함

이 상황에서 핵심은 정답을 맞히는 능력이 아니라, 판을 뒤집는 설계(새 논리 구조)입니다.

흔히 System 2(심사숙고)라고 부르는 영역이 여기에 해당합니다.


3. 핵심 주장: 사람의 ‘실수’는 결함이 아니라 기능.

여기서 반전으로 들어가겠습니다.
사람의 실수는 보통 부정확함으로 취급되지만, 특정 조건에서는 오히려 추론이 작동하고 있다는 신호가 됩니다.

이를 이해하려면, 두 개념을 구분해야 합니다.

  • 환각(Hallucination): 근거가 부족한데도 그럴듯한 확정 답을 만들어내는 현상
  • 가설(Hypothesis): 현재 증거가 부족하므로, 검증 가능하도록 후보 원인을 세우고 다음 관측/실험으로 이어지는 주장

AI도 가설을 제시할 수는 있습니다.

다만 실무에서 자주 발생하는 문제는, AI가 제시한 내용이 가설인지 확정인지 경계가 흐려질 때입니다.

말은 단정인데 근거는 빈약한 형태가 나오면, 현장에서는 리스크가 됩니다.

반면 인간의 실수는(정상적인 업무 프로세스 안에서는) 다음 형태로 나타날 때 가치가 있습니다.

  1. 현재 데이터로는 결론이 나지 않음을 인정
  2. 원인을 소수의 후보로 압축(가설화)
  3. 검증 비용이 낮고 정보 이득이 큰 실험을 설계
  4. 실패를 통해 시스템 모델을 업데이트

즉, 사람의 실수는 OOD(분포 외 상황)에서 세계 모델을 구성하려는 시도로 나타날 수 있습니다.
아이러니하지만, 데이터가 부족한 상황에서 사람이 하는 ‘틀림’은, 종종 검증 가능한 다음 행동을 낳습니다.

이 글에서 말하는 실수의 위대함은 단순한 감성적인 표현이 아니라 다음 의미입니다.

실수가 근거 없는 확신이 아니라 검증 가능한 가설의 형태를 띨 때, 그것은 추론의 결함이 아니라 추론의 작동 방식입니다.

구분 AI (확률적 실행자) 사람 (가설적 아키텍트)
주요 영역 In-Distribution (패턴 재조합) Out-of-Distribution (분포 외 추론)
오류의 성격 환각 : 근거 없는 확신 가설: 근거 있는 불완전함
추론 방식 System 1 (직관 / 속도) System 2 (심사숙고 / 검증)
핵심 가치 생산성 극대화 (How) 방향성 결정 및 책임 (What / Why)

4. 결론: 빌더(Builder)에서 아키텍트(Architect)로 이동해야 한다.

그렇다면 생존 전략은 명확해집니다.
AI가 강해질수록 사람에게 남는 영역은 “How”가 아니라 “What/Why” 쪽으로 이동합니다.

  • What: 무엇을 만들 것인가(문제 정의, 성공 조건, 범위)
  • Why: 왜 이것이 우선인가(가치, 리스크, 제약, 트레이드오프)
  • 검증 설계: 무엇을 측정해야 실패를 빨리 알 수 있는가
  • 경계 설정: 무엇을 고정하고 무엇을 가변으로 둘 것인가
  • 책임: 그 판단을 그럴듯함이 아니라 증거로 정당화할 수 있는가

AI는 훌륭한 실행자이자 보조자입니다.
그러나 문제를 어떤 형태로 정의하고, 어떤 증거로 검증할지는 아직 사람이 주도해야 합니다.

그리고 이 영역이 자동화되기 어렵다는 이유는 기술 이전에 현실적입니다.

목표와 제약, 그리고 가치 판단은 결국 사람과 조직의 선택이기 때문입니다.

관련글


개발자의 종말? 구현의 민주화

Know-how의 시대가 저물고What & Why를 정의하는 시대가 온다.개발자의 시대 2015년부터 시작된 개발자 붐이 갑작스레 막을 내리고 있습니다. 그 당시 게임업계 대기업 3사(3N)의 연봉인상 릴레이부터

chessire.tistory.com