GitHub - chessire/shelter-puppy
Contribute to chessire/shelter-puppy development by creating an account on GitHub.
github.com
AI는 한 덩어리가 아닙니다.
역할이 다른 도구들을,
한 대의 맥 위에 포개는 일입니다.
"유기견 입양에 AI를 붙인다"고 하면, 보통 이렇게 떠올립니다.
"그냥 ChatGPT API 부르면 되는 거 아냐?"
틀린 말은 아닙니다. 하지만 이 출발점은 정작 중요한 걸 가립니다. 강아지 정보와 영상 같은 데이터가 매 호출마다 외부로 나가고, 호출량만큼 비용이 붙고, 모델·데이터의 통제권은 내 손을 떠납니다. 작은 비영리 명분 사업에서 이 셋은 가볍지 않은 비용입니다.
그래서 질문을 바꿨습니다.
"무엇을 내 손 안(로컬)에 두고, 무엇만 밖에 맡길 것인가?"
이 글은 그 경계를, 노트북 한 대 위에 세우는 과정입니다. 선택의 이유는 다음 편으로 미루고, 이번 편은 "무엇을 어떻게 깔았는가"만 다룹니다.
1. AI 플랫폼을 설계하다 - 한 대의 맥에 무엇이 올라가나
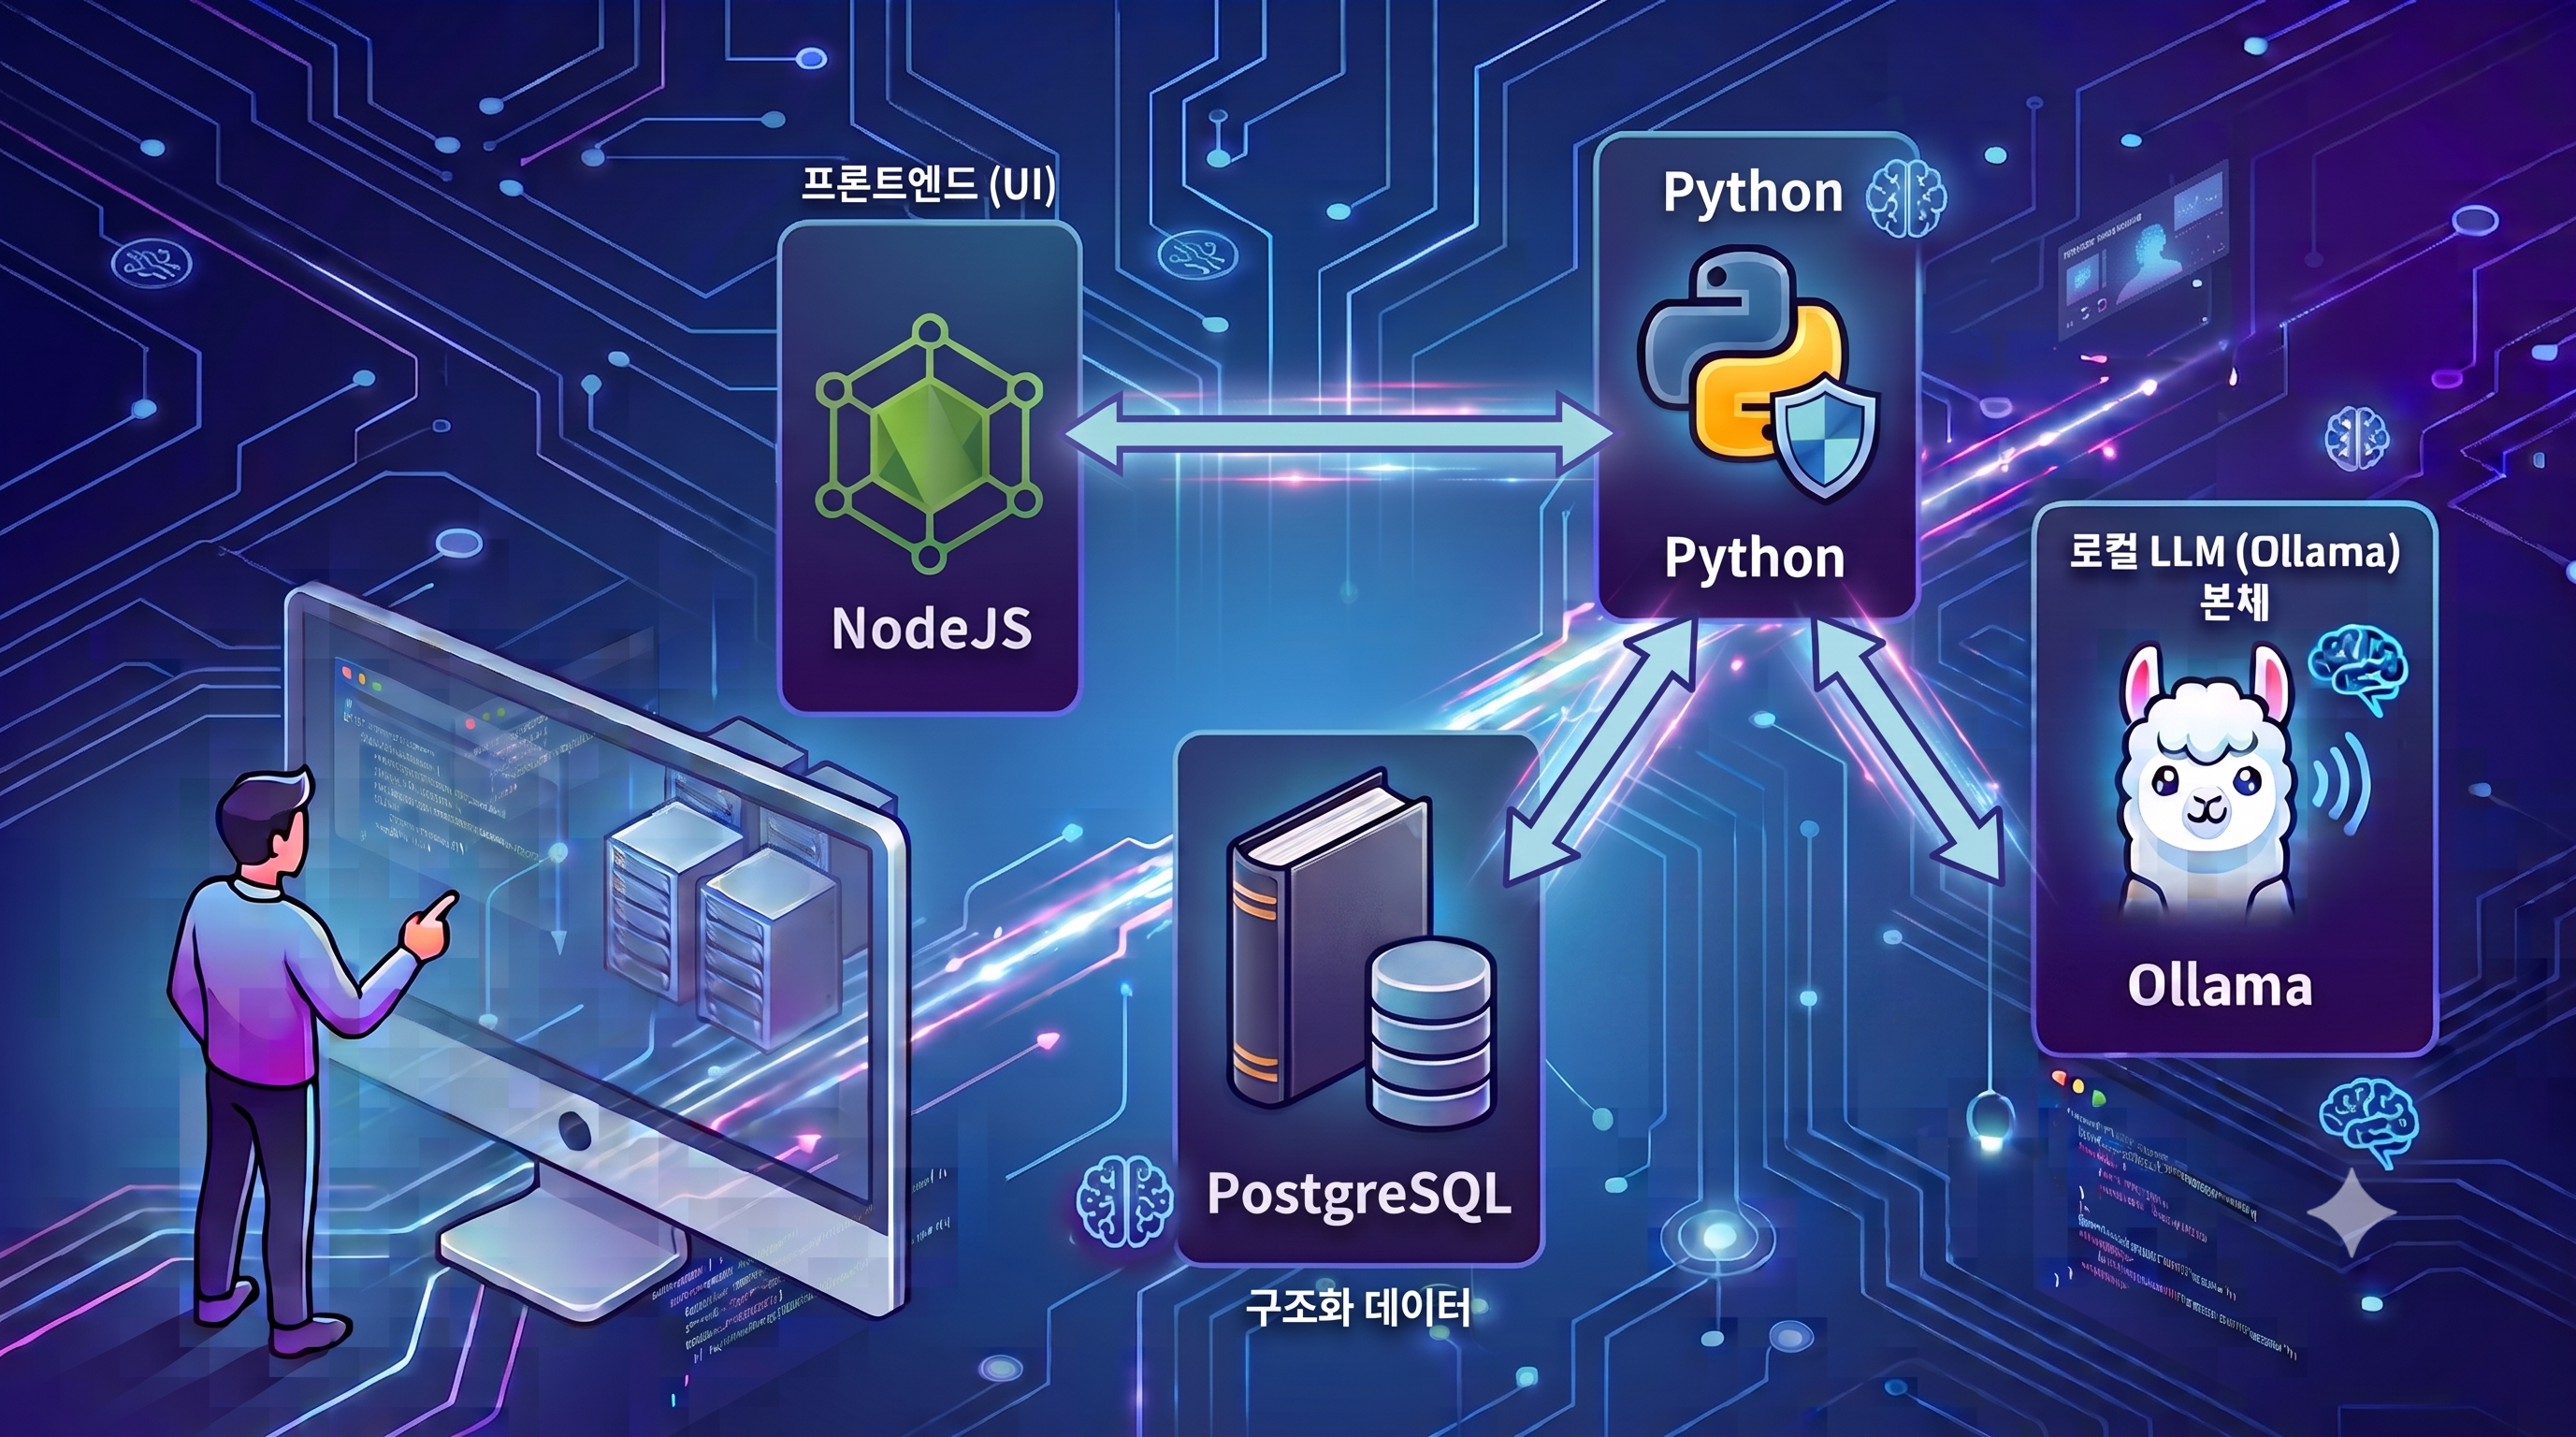
세울 것은 세 개의 계층입니다.
- Python 계층 — AI 코드(LLM·RAG·영상)와 백엔드(Django)가 같은 언어로 도는 곳.
- 데이터 계층 — 표 형태 데이터를 담는 PostgreSQL.
- Node 계층 — 화면(React)을 띄우는 프론트엔드 런타임.
핵심은, 이질적으로 보이는 이 조각들이 대부분 파이썬 하나로 묶인다는 점입니다. 강아지 공고 관리도, 응대봇도, 영상 분석도 전부 파이썬 위에서 돕니다. 그래서 환경설정의 무게중심도 자연히 파이썬에 실립니다.
2. Python 계층 - AI와 백엔드가 같은 언어로 돈다
맥 기본 파이썬은 버전이 낡아 개발용으로는 권장되지 않습니다. brew로 최신을 깔고, 프로젝트 전용 가상환경(venv)을 만듭니다.
brew install python
python3 --version          # 3.12 / 3.13 나오면 OK
which python3              # /opt/homebrew/bin/python3 이면 brew 거 잡힌 것

# 프로젝트 전용 가상환경
python3 -m venv ~/ai/venv
source ~/ai/venv/bin/activate   # 프롬프트에 (venv) 뜨면 활성
pip install -U pip
그 위에 세 묶음을 올립니다. LLM·RAG 스택, 영상 파이프라인, 그리고 백엔드(Django).
# LLM·RAG — 로컬 모델 클라이언트 + 벡터DB
pip install ollama chromadb

# 영상 파이프라인
brew install ffmpeg                            # 영상 자르기·인코딩·자막 입히기
pip install opencv-python                      # 프레임 추출
pip install ultralytics                        # YOLO(검출) + ByteTrack(추적)
pip install mlx-audio soundfile sounddevice    # TTS — 대본을 나레이션 음성으로 (애플 실리콘 최적)

# 백엔드 — Django + REST + DB 드라이버
pip install django djangorestframework django-cors-headers psycopg2-binary
django-admin startproject config .        # 현재 폴더에 프로젝트 생성
python manage.py runserver                # http://127.0.0.1:8000 뜨면 OK
로컬 LLM 본체인 Ollama는 코드 라이브러리가 아니라 독립 서버라 brew로 깝니다. 위에서 깐 ollama(pip)는 그 서버를 파이썬에서 부르는 리모컨이고, 지금 까는 본체가 TV입니다.
brew install ollama
brew services start ollama        # 재부팅해도 자동으로 뜨는 백그라운드 서비스

ollama pull bge-m3                 # 임베딩 모델 (작고 빠름, 첫 성공)
ollama pull gemma4:26b-a4b-it-q4_K_M   # 멀티모달 본체 (비전+텍스트)

ollama run gemma4:26b-a4b-it-q4_K_M "안녕, 한국어 돼?"   # 응답 나오면 /bye
이 한 덩어리만으로 "텍스트를 벡터로 바꾸고(bge-m3), 의미가 비슷한 데이터를 꺼내(chromadb), 그걸 보고 답하는(gemma)" 응대봇의 뼈대가 한 대의 맥 안에 들어옵니다.
3. PostgreSQL - 구조화 데이터의 자리
회원, 강아지 공고, 입양 신청처럼 행과 열로 떨어지는 데이터는 관계형 DB에 둡니다.
brew install postgresql
brew services start postgresql    # ollama처럼 백그라운드 서비스로
조금 전 깐 chromadb와는 역할이 다릅니다. postgres는 구조화 데이터, chromadb는 의미 검색용 벡터입니다. 대체재가 아니라 함께 씁니다. (왜 둘 다 필요한지는 다음 편에서.)
4. Node 계층 - 화면을 띄우다
프론트엔드(React)를 돌릴 런타임입니다.
brew install node          # node + npm 같이 들어옴
node --version             # 20 이상

npm create vite@latest     # React 선택 (MVP용 SPA)
MVP는 가볍고 빠른 Vite + React로 갑니다. 검색 노출(SEO)이 필요한 프로덕트 단계에서 SSR 프레임워크로 넘어갈 여지를 남겨두지만, 그 갈림길의 이야기도 다음 편 몫입니다. (참고로 create-react-app은 폐기되어 쓰지 않습니다.)
맺음말
여기까지가 골격입니다.
- Python 하나에 AI와 백엔드를 포개고,
- Postgres로 구조화 데이터를 받치고,
- Node로 화면을 띄운다.
겉으로는 그저 brew install과 pip install의 나열처럼 보입니다. 하지만 이 배치에는 일관된 선택이 하나 깔려 있습니다. 가능한 많은 것을 외부 API가 아니라 내 손 안에 두는 것. 왜 굳이 로컬인지, 왜 FastAPI가 아니라 Django인지, 그리고 영상 분석을 왜 전부 LLM에 맡기지 않는지 — 이 환경을 이렇게 세운 이유는 다음 편에서 풀어가겠습니다.
이 글에서 다룬 고정 함수 분류층은 ProjectDavid의 일부입니다.
전체를 바닥부터 만드는 과정은 강의 3부작으로 정리하고 있고, 10월에 오픈 예정입니다.
→ 오픈 알림 받기
다음글
로컬 LLM 아키텍처 - Local First AI
1. 강아지를 입양했다기술을 먼저 정하고 문제를 찾은 게 아닙니다.한 마리를 데려오고 나서야풀어야 할 문제가 보였습니다. AI로 무언가를 만들어보려던 참이었습니다. 도구는 손에 있는데 무
chessire.tistory.com
관련글
오픈소스 LLM vs 빅테크 LLM API: AI 사업의 비용과 리스크
모델은 커모디티가 된다.마진은 판단에 남는다. 2025년 2월, OpenAI는 당시 가장 비싼 모델 GPT-4.5를 출시했습니다. 백만 토큰당 입력 75 달러, 출력 150 달러. 그리고 다섯 달이 지나기 전, API에서 제거
chessire.tistory.com
'AI > Pipeline' 카테고리의 다른 글
| LLM은 지시만: 프롬프트 오염을 막는 설계 - Ownership First AI (0) | 2026.07.23 |
|---|---|
| 로컬 TTS(mlx-audio)로 영상 타임라인 컨트롤 - Narration First AI (0) | 2026.07.20 |
| 결정론적 AI 파이프라인 설계 - Deterministic First AI (0) | 2026.07.13 |
| YOLO11 해상도 함정: 골든셋으로 검증 - Measurement First AI (0) | 2026.07.08 |
| 로컬 LLM 아키텍처 - Local First AI (0) | 2026.07.06 |