Coherency Miss(일관성 미스)로 보는
캐시 라인 전쟁과 해결 전략,
alignas(64)는 속도가 아니라
멀티코어 안정성이다.
싱글 스레드 최적화는 보통 캐시 히트율로 설명이 끝납니다.
하지만 멀티스레드에 들어가면 캐시 미스의 얼굴이 하나 더 늘어납니다.
Coherency Miss(일관성 미스).
이건 캐시에 없어서가 아니라, 다른 코어가 내 캐시 라인을 건드려서 내 캐시가 무효화(invalidate)되는 미스입니다. 즉, 데이터가 원래 캐시에 있었는데도, 멀티코어 환경 때문에 있었지만 없어진 것이 됩니다.
1) Coherency Miss란 무엇인가
멀티코어 CPU는 각 코어가 L1/L2 같은 빠른 캐시를 따로 들고 있습니다.
그럼 문제가 생겨요.
- 코어 A가 어떤 메모리 주소 X를 캐시에 들고 있음
- 코어 B도 같은 주소 X를 캐시에 들고 있음
- 코어 B가 X를 쓰기(write) 하면?
- 코어 A가 들고 있던 X는 더 이상 최신이 아님
그래서 CPU는 캐시 일관성 프로토콜(MESI 계열)로 누가 최신인지를 맞춥니다.
이때 흔히 일어나는 현상이:
- invalidate(무효화): 다른 코어가 수정한 라인을 내 캐시에서 폐기
- 다음에 내가 읽을 때는 다시 가져와야 함 → coherency miss
이게 Coherency Miss의 정체입니다.
핵심은 데이터가 멀리 있어서 느린 게 아니라, 서로 방해해서 느린 것입니다.
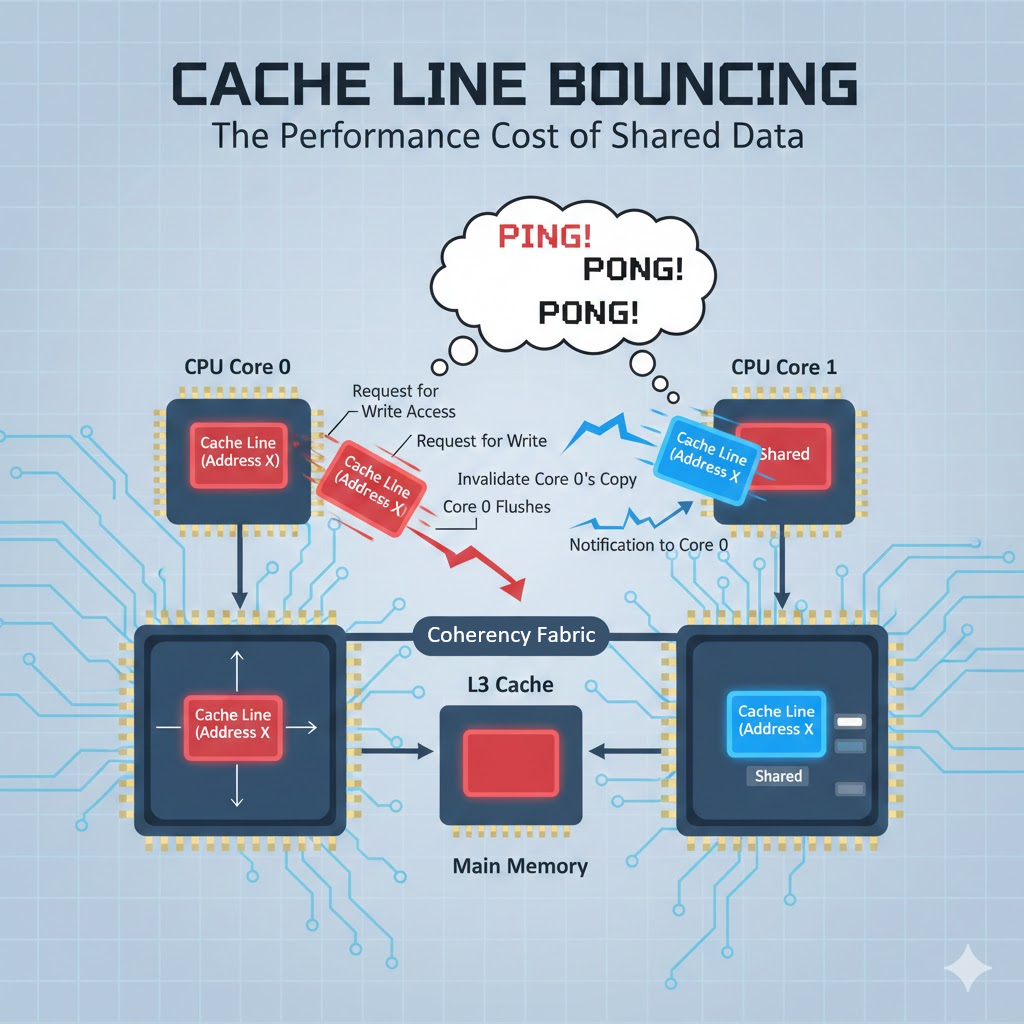
2) False Sharing: 같은 데이터를 공유한 적이 없는데 공유가 발생한다
False Sharing(거짓 공유)은 더 악질입니다.
두 스레드가 서로 다른 변수를 쓰는데도 느려져요.
왜냐하면 캐시는 변수 단위가 아니라 캐시 라인(보통 64B) 단위로 일관성을 맞추기 때문입니다.
예를 들어, 같은 캐시 라인 안에 아래 두 변수가 들어있다고 하자.
- counterA (스레드 A가 계속 증가)
- counterB (스레드 B가 계속 증가)
둘은 다른 변수고, 논리적으로는 공유가 아닙니다.
하지만 캐시 라인 단위로 보면 둘은 같은 64B 박스 안에 들어 있음.
그러면 벌어지는 일:
- 스레드 A가 counterA++
→ 해당 캐시 라인(64B)을 쓰기 가능한 최신 상태로 만들기 위해 독점화 - 스레드 B가 counterB++
→ 똑같은 캐시 라인을 독점화하려고 함
→ A 쪽 라인 invalidate - A가 또 counterA++
→ 다시 라인 가져오고 invalidate 반복
이게 흔히 말하는 ping-pong입니다.
캐시가 공처럼 튕기면서 coherency 트래픽이 폭발하고, 성능이 급격히 떨어집니다.
즉, False Sharing은 데이터 공유가 아니라
캐시 라인 공유가 문제입니다.
3) 왜 alignas(64)는 속도가 아니라 안정성인가
많은 사람들이 alignas(64)를 빠르게 하려고 붙입니다.
하지만 멀티스레드에서 alignas(64)의 진짜 목적은 다른 쪽입니다.
서로 다른 스레드가 쓰는 데이터가 같은 캐시 라인에 들어가지 않게 보장하는 것.
즉, False Sharing을 구조적으로 차단하는 장치입니다.
여기서 속도라는 표현이 위험한 이유가 있어요.
- 싱글 스레드에서 alignas(64)는 오히려 패딩이 늘어 캐시 효율을 떨어뜨릴 수 있음
- 멀티스레드에서 alignas(64)는 패딩을 감수하더라도 coherency 폭발을 막아 성능을 안정화함
그래서 alignas(64)는 평균 성능 상승이 아니라
최악의 경우를 제거하는 안정성 장치에 가깝습니다.
4) 멀티스레드에서 캐시 라인을 분리/배치하는 실전 전략
아래는 현업에서 바로 적용하는 순서입니다.
(1) 쓰기를 분리하라: write-hot 데이터부터 격리
False Sharing은 거의 항상 write-write 또는 write-read에서 터집니다.
그래서 먼저 찾아야 하는 건:
- 여러 스레드가 자주 쓰는 변수(카운터, 플래그, 상태값, work queue head/tail 등)
이런 변수는 각 스레드 전용 구조체로 분리하거나, 최소한 캐시 라인을 분리해야 합니다.
(2) Thread-local(스레드 로컬)로 바꾸고 마지막에 합쳐라
공유 카운터를 매번 증가시키는 대신:
- 스레드별 로컬 카운터에 누적
- 프레임 끝/작업 끝에 한 번 합산(reduction)
이건 캐시 최적화라기보다 coherency 최적화입니다.
(3) 구조체를 역할로 쪼개라: read-mostly vs write-hot
AoS/SoA와 같은 결로, 멀티스레드에서도 데이터는 성격이 갈립니다.
- read-mostly(거의 안 변함): 공유해도 비교적 안전
- write-hot(자주 변함): 공유하면 폭발
write-hot만 따로 빼서 alignas(64)를 주는 식으로,
전체 구조체에 무작정 패딩을 박지 않는 게 포인트입니다.
(4) 캐시 라인 패딩 패턴(실전 템플릿)
가장 흔한 패턴:
struct alignas(64) ThreadCounter
{
	std::atomic<uint64_t> value;
	char pad[64 - sizeof(std::atomic<uint64_t>)];
};
핵심은 변수 하나를 64B 박스 하나에 고정시키는 것.
이러면 서로 다른 스레드의 카운터가 같은 라인에 섞일 일이 없습니다.
(5) 큐/링버퍼는 헤더와 테일을 분리한다
멀티프로듀서/멀티컨슈머 구조에서 자주 터지는 포인트가:
- head / tail
- size / flags
이런 메타데이터가 같은 캐시 라인에 붙어있으면 False Sharing이 쉽게 납니다.
헤더와 테일을 다른 캐시 라인으로 분리하면 체감이 크게 바뀌는 경우가 많습니다.
5) 체크리스트: 이 증상이면 False Sharing을 의심해라
- 스레드를 늘렸는데 성능이 안 오르거나 오히려 떨어진다
- CPU 사용률은 높은데 처리량이 늘지 않는다
- 특정 공유 카운터/플래그를 제거하면 성능이 갑자기 좋아진다
- 동일 코드를 단일 스레드로 돌리면 안정적이다
이 경우는 연산 최적화가 아니라
coherency/false sharing 최적화를 먼저 의심하는 게 맞습니다.
마무리
Coherency Miss와 False Sharing은 캐시가 부족해서가 아니라
캐시가 서로 싸워서 생기는 성능 붕괴입니다.
그래서 alignas(64)는 “빠르게 만들기”가 아니라
멀티코어에서의 안정성(최악 제거)을 위한 설계 도구입니다.
다음글
현대 CPU 최적화의 본질: 연산(ALU)이 아닌 메모리(LSU)
CPU는 연산보다데이터를 가져오는 방식에훨씬 민감하다.CPU 최적화를 연산을 줄이는 일로만 보면, 체감 성능이 잘 안 나옵니다. 실전 병목은 대개 계산(ALU)이 아니라 메모리 접근(Load/Store)에서 터
chessire.tistory.com
'Notes > Computer Science' 카테고리의 다른 글
| Invalidate를 줄이는 법: MESI로 이해하는 캐시 라인 소유권 경쟁 (0) | 2026.03.26 |
|---|---|
| 현대 CPU 최적화의 본질: 연산(ALU)이 아닌 메모리(LSU) (0) | 2026.03.12 |
| OSI 7계층과 TCP/IP 4계층 (0) | 2010.08.23 |
| 네트워크의 주소체계와 데이터 정렬 (0) | 2010.08.17 |
| DBMS의 종류(관계형, 객체지향형, 객체관계형) (1) | 2010.08.14 |