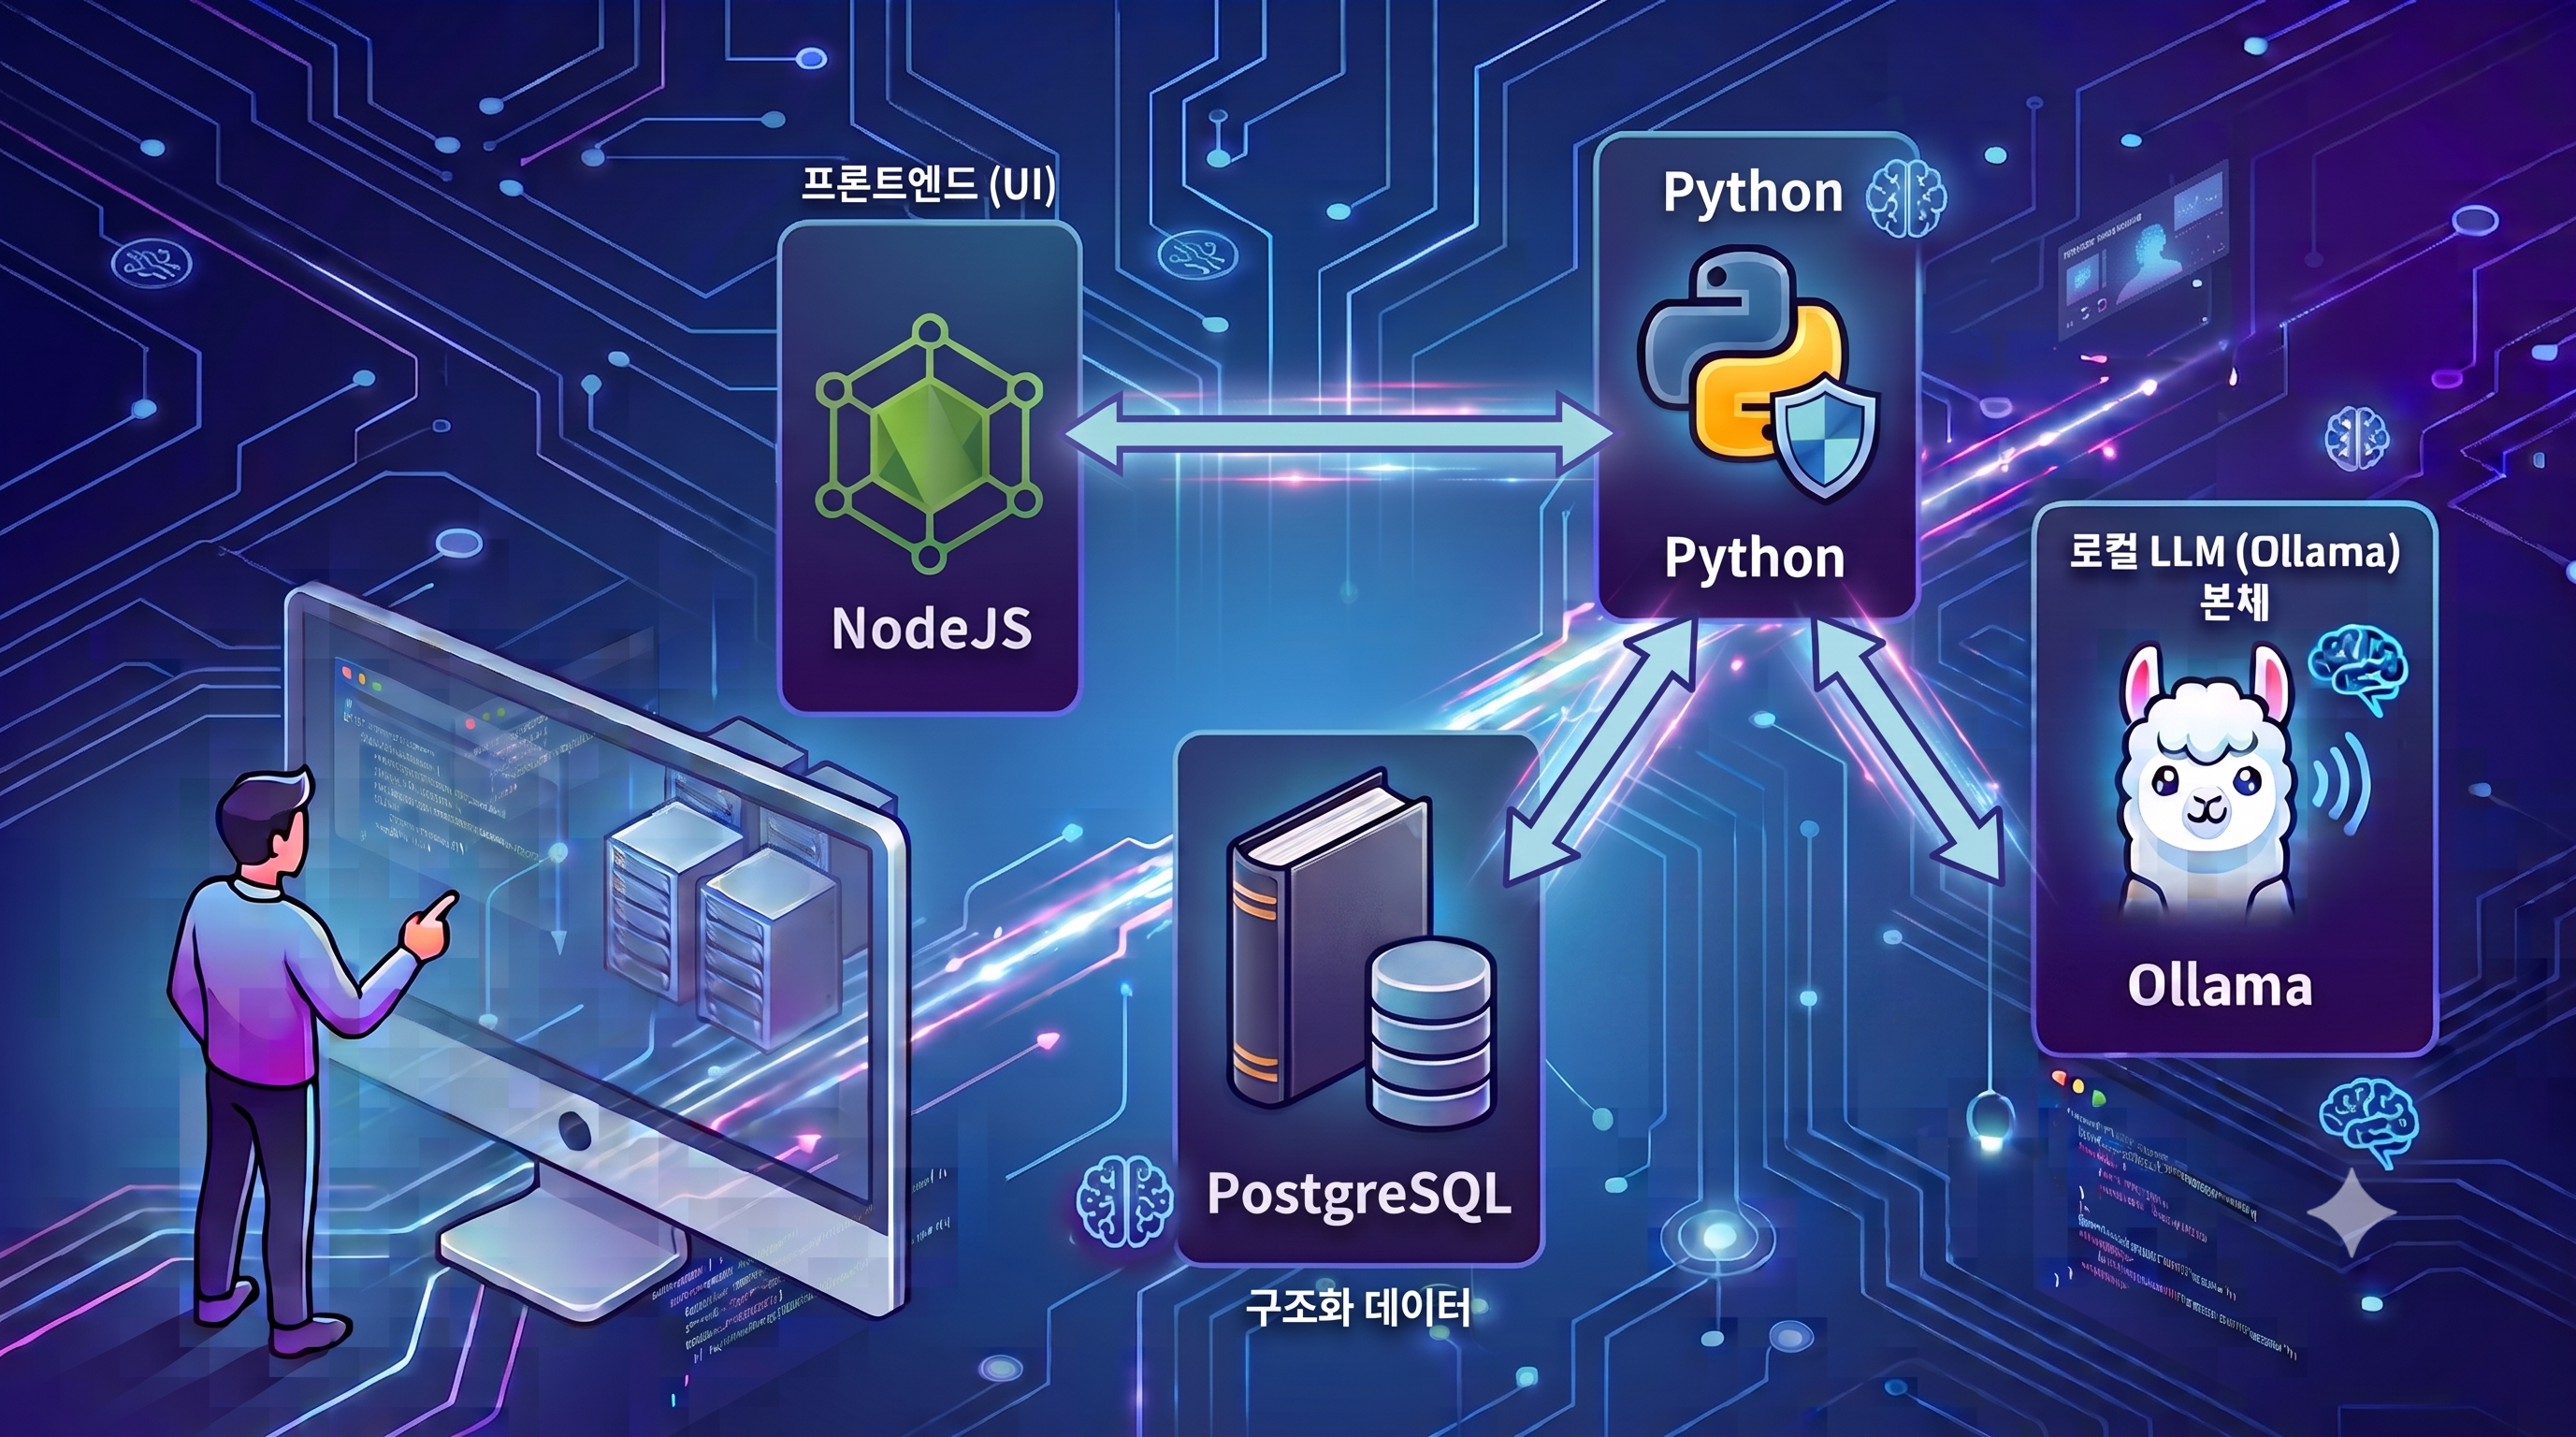
GitHub - chessire/shelter-puppy
Contribute to chessire/shelter-puppy development by creating an account on GitHub.
github.com
임베딩은 진위를 가리지 않고,
유사도를 잽니다.
검수는 검색 뒤가 아니라,
저장 앞에 세웠습니다.
영상을 만드는 이야기는 지난 편에서 일단락 됐습니다. raw 영상 아홉 개가 4분 만에 내레이션 붙은 숏폼이 되는 파이프라인이었습니다. 이제 상담 봇을 제작할 차례입니다.
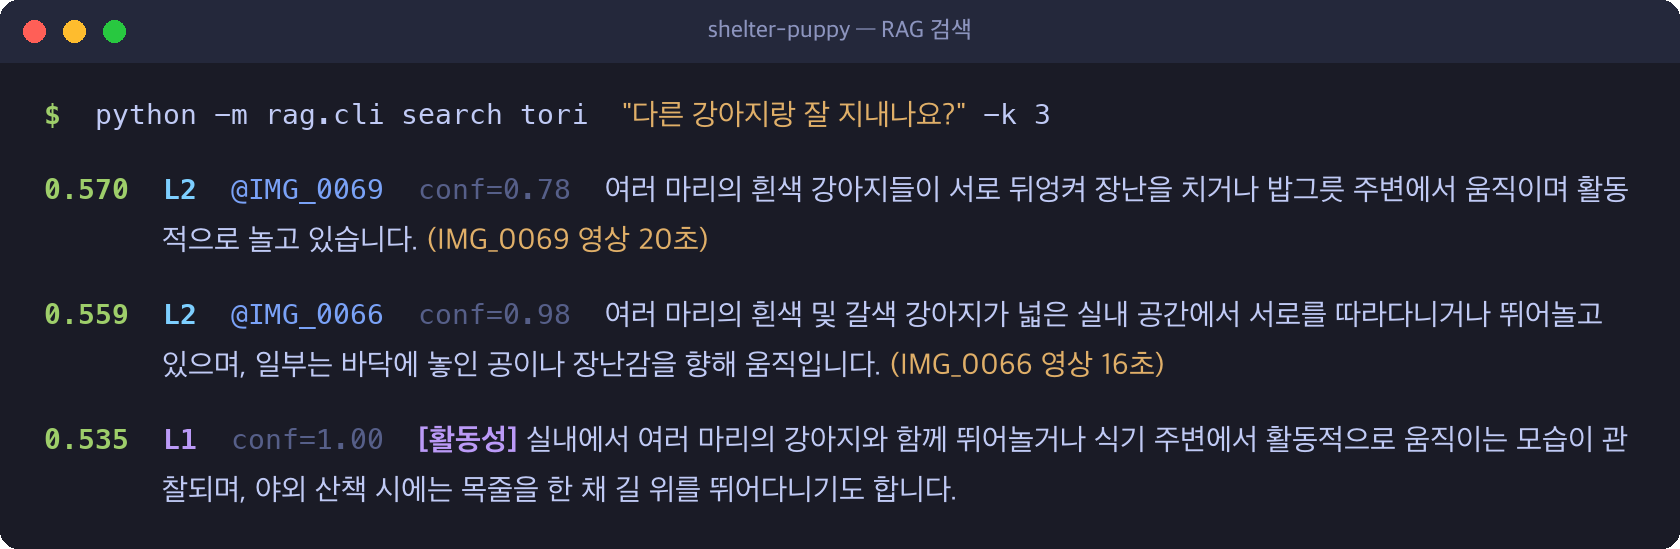
"다른 강아지랑 잘 지내나요?"
입양 문의입니다. 영상은 관심을 만들고, 관심은 질문이 됩니다. 질문에 답하려면 그 강아지에 대한 기록이 필요하고, 기록을 담을 저장소가 필요합니다. 그래서 2부의 첫 작업은 봇이 아니라 DB입니다. 이번 편은 Postgres + pgvector + bge-m3로 로컬 RAG 저장소를 설정하고, 영상 아홉 개를 인제스트 해서 위 질문에 타임스탬프 붙은 관찰 기록이 검색되기까지의 기록입니다.
python -m rag.cli search tori "다른 강아지랑 잘 지내나요?" --card
RAG를 붙이면 환각이 해결되지 않을까?
이번 함정은 그 기대 자체에 있습니다. RAG의 약속은 "문서에 근거하여 답한다"입니다. 그런데 이 약속에는 전제가 하나 숨어 있습니다. 문서가 사실이어야 한다. 이 시스템의 문서는 사람이 쓴 글이 아니라 기계가 영상을 보고 적은 텍스트입니다. 캡션, 행동 서술, 그리고 그것들을 묶은 요약이죠. LLM이 지어낸 문장이 DB에 한 번 들어가면 검색은 그 문장을 성실하게 찾아주고, 봇은 자신 있게 인용합니다. 임베딩 점수가 아무리 높아도 그건 질문과 비슷하다는 뜻이지, 사실이라는 뜻은 아닙니다.
그래서 이번 편의 규칙은 검색 튜닝이 아니라 저장 규칙입니다.
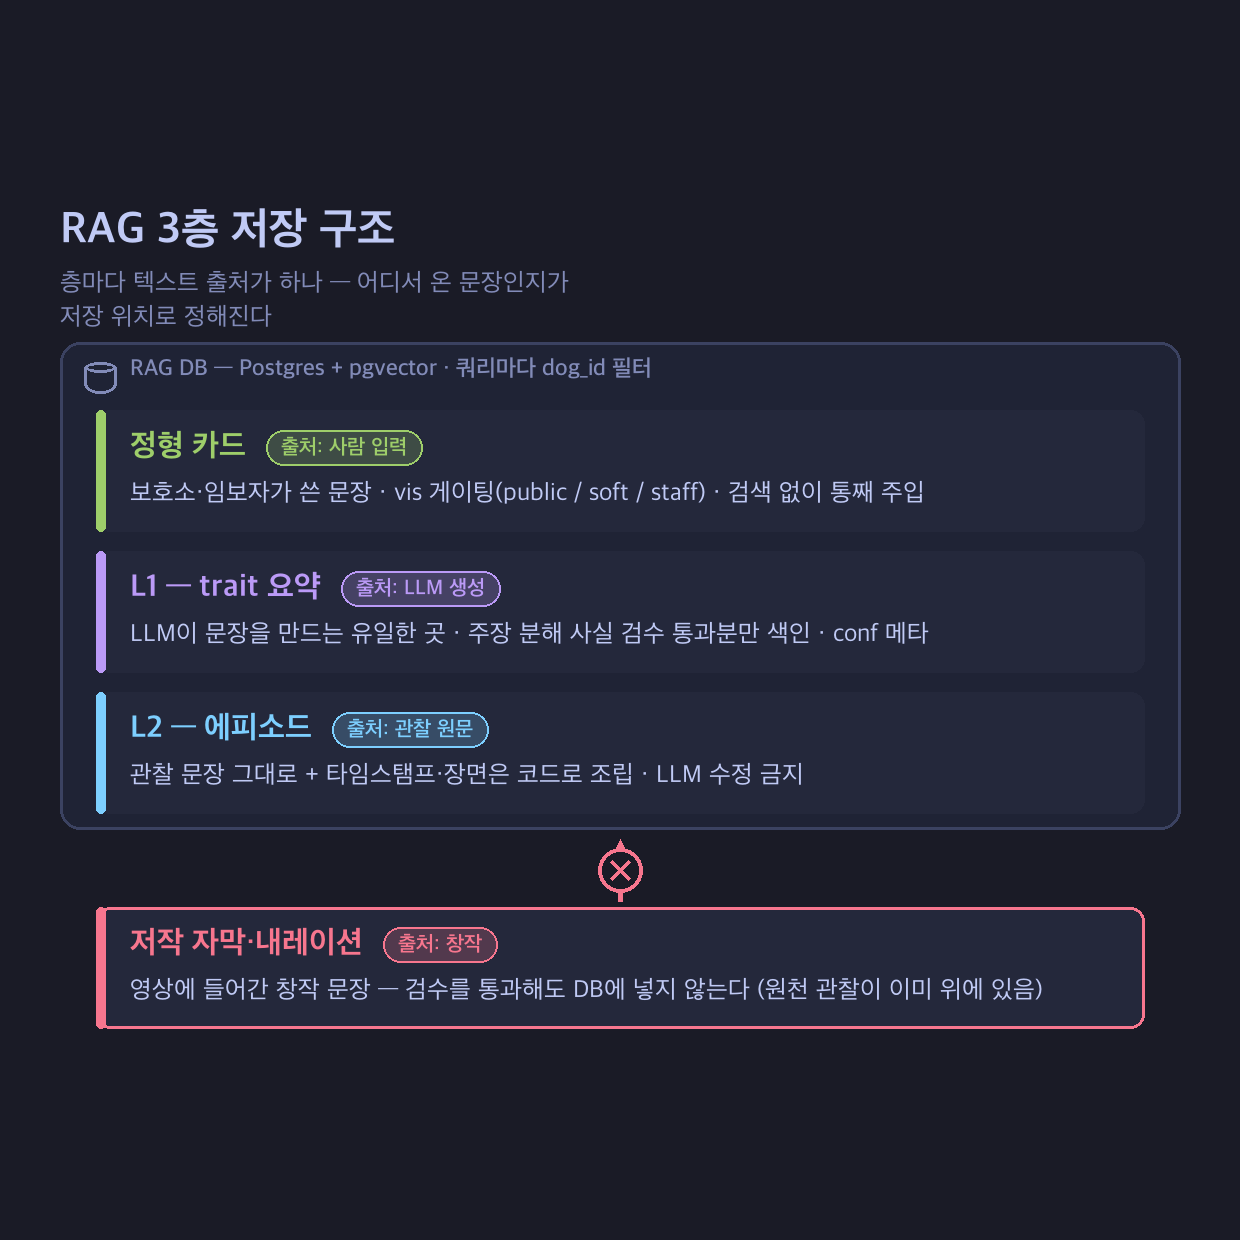
문장의 출처로 저장 위치를 정한다.
LLM이 문장을 만드는 곳은 한 곳이고,
그 문장은 검수를 통과해야 저장된다.
20. 출처로 저장 위치를 정한다 - 스키마 설계
구축 자체는 별 것 없었습니다. Postgres는 이미 설치해두었고, pgvector를 얹어 CREATE EXTENSION vector 한 줄을 호출했습니다. 임베딩은 Ollama의 bge-m3를 사용했습니다. "잘 지내나요?"라는 한국어 질문과 한국어 관찰 기록을 같은 벡터 공간에 놓아야 하다보니 다국어 임베딩이 필요해서 선택했습니다. 클라이언트는 기존 venv의 psycopg2와 ollama 그대로라 추가 파이썬 의존성 0으로 로컬 스택은 1부에서 세운 그대로입니다. 구성은 schema.sql, db.py, embed.py, ingest.py, retrieve.py, cli.py(init / card / ingest / search)입니다. 단위 테스트 11개도 추가되었습니다.
추가적인 설계가 들어간 곳은 스키마입니다. 발단은 사소한 질문이었습니다.
"할루시네이션이 걱정되니 텍스트에 LLM 저작이 얼마나 섞였는지, 비율을 메타데이터로 넣을까?"
출처를 연속값 컬럼으로 기록하자는 발상인데, 구상 끝에 결정을 바꿨습니다. 인제스트하는 시점에 코드는 이 텍스트가 어디서 왔는지 이미 알고 있습니다. 그 사실을 컬럼에 다시 적는 건 군더더기고, 비율이라는 연속값은 "이 문장을 믿어도 되는가"라는 이진 질문에 답하지 못합니다. 대신 출처로 저장 위치를 구분했습니다.
| 자리 | 저자 | 규칙 |
| 카드 | 사람 | 보호자가 입력한 정형 정보. 백신·구조 이력 같은 사실. |
| L2 청크 | 기계 관찰 원문 | 영상 분석이 적은 그대로. LLM 수정 금지 — 원문이 청크의 부분문자열로 보존되는 것을 테스트로 고정. |
| L1 청크 | LLM | 파이프라인 전체에서 LLM이 새 문장을 만드는 유일한 곳. 검수 필수(다음 절). |
| 저작 자막 | — | DB에 넣지 않음. 연출용 문장은 사실 저장소에 섞이지 않습니다. |
L2는 코드가 조립합니다. 행동 서술에는 인용 타임스탬프를 붙이고(신뢰도 0.7 이상, 비uncertain 구간 중 최고 신뢰도), 확정된 장면 태그를 합칩니다. 6편에서는 필드의 소유권으로 갈랐다면, 이번에는 문장의 저자로 가른 셈입니다.
노출도 통제했습니다. 카드 필드는 3단 가시성이라 구조 위치 같은 스태프 정보는 검색에 나오지 않고, 민감한 필드는 순화본만 노출됩니다. e2e에서 게이팅이 그대로 작동하는 것까지 확인했습니다.
21. LLM의 문장은 검수를 통과해야 저장된다 - L1 요약
L1은 강아지 한 마리의 관찰 전체를 묶은 요약입니다. "활발하고 다른 개들과 잘 어울립니다" 같은. 상담 봇 입장에서 가장 쓰기 좋은 텍스트지만, 동시에 이 저장소에서 유일하게 LLM이 지어낼 수 있는 텍스트입니다. 그래서 저장 전에 관문을 세웠습니다.
절차는 이렇습니다. Gemma가 요약을 쓰고(temperature 0.2, 프롬프트는 지시만 — 6편의 규칙 그대로) → 요약을 주장 단위로 분해 > 주장마다 관찰 기록과 대조 > 근거 없는 주장은 증거 범위로 제한해 재작성 > 그래도 근거 미달이면 드롭. 요약이 통째로 비어도 시스템은 무너지지 않습니다. L2와 카드가 남으니까요. 요약은 편의성을 위한 것이지 진실의 원천이 아닙니다. 위층이 무너져도 아래층이 받치는 안전한 저하 구조입니다.
검수 기능은 새로 만들지 않았습니다. 자막 사실 검수에 쓰던 기능(주장 분해, 근거 대조)을 파이프라인에서 그대로 import 했습니다.
판정 단위는 한 번 나눴습니다. 자막 검수는 all-fit입니다. 블록에 들어간 모든 소스가 주장을 받쳐야 통과합니다. 하지만 L1은 강아지 전체의 요약이라 **기록이 하나라도 맞다면 근거(any-fit)**로 정했습니다. "다른 강아지와 잘 논다"는 주장은 아홉 영상 중에서 한 영상에서만 특정 되어도 성립하니까요.
그리고 e2e에서 이 관문이 실제로 발동했습니다.
- "고양이와 서로 마주 보고 앉아 있음", 사교성의 근거로 미달 판정.
- "움직임 없이 정지해 있는 상태", 안정성의 근거로 미달 판정.
둘 다 그럴듯합니다. 마주 보고 앉아 있으면 사교적인 것 같고, 정지해 있으면 안정적인 것 같죠. 검수 기능은 그 동의어 경계에서 보수 쪽으로 판정했고, 두 문장은 증거 범위로 재작성된 뒤에야 통과했습니다. 정밀도를 우선하였기에 설계 의도는 그대로였습니다. 입양 문의에 답하는 시스템에서 "그럴듯한데 근거 없는 말"은 가장 비싼 오류입니다.
22. 신뢰 경계는 DB 앞까지 - 게이트와 멱등
저장 규칙만큼 중요한 것이 게이트입니다.
첫째, re-ID 게이트. 잡에 재식별 미확정(foster_uncertain)이 남아 있으면 인제스트 자체를 거부합니다. 1부에서 재식별을 카드 한 장, 탭 한 번으로 확정하게 만들었는데, 그 신뢰 경계가 DB 입구까지 연장된 겁니다. 누구의 것인지 확정되지 않은 관찰은 그 강아지의 기록이 될 수 없습니다. "일단 넣고 나중에 지우자"는 없습니다. 지우는 걸 잊는 날이 오니까요.
둘째, 재인제스트 멱등. video_id는 소스 파일명입니다. 같은 영상을 다른 잡에서 다시 인제스트하면 중복이 아니라 갱신입니다. 영상 분석은 업서트, L2는 그 영상의 청크를 지우고 재삽입, L1은 그 강아지 전체를 재생성합니다. 실측으로 확인했습니다. 같은 잡을 두 번 인제스트한 전후 행 수가 동일합니다. 유저 요청 원문은 저장하지 않아서 요청에서 유래하는 데이터는 자동 장면 태그가 유일하고, 그것도 set 병합이라 누적되지 않습니다.
한계도 적어두겠습니다. 파일명이 곧 정체성이라, 다른 푸티지가 같은 파일명으로 오면 중복이 아니라 덮어쓰기가 됩니다. 영상이 본격적으로 누적되는 운영 전에 콘텐츠 해시 같은 정체성 강화가 필요합니다. 나중에 구현할 수 있도록 남겨뒀습니다.
셋째, 재집계는 DB 기반. L1 재생성은 잡 디렉토리가 아니라 DB에 쌓인 영상 분석을 읽습니다. 잡 폴더를 정리해도 요약은 다시 만들 수 있고, 영상이 쌓일수록 요약이 두꺼워집니다. 임시 산출물과 축적 데이터의 경계를 여기서 그었습니다.
23. "모른다"는 분포에서 나온다 - 검색 스모크
인제스트 결과는 영상 9개 → L2 18청크, L1 4청크. 여기에 질문 네 종류를 던졌습니다.
- 사교성 질문("다른 강아지랑 잘 지내나요?") > 놀이 장면 관찰 2건이 타임스탬프와 함께 상위(0.56~0.57), 활동성 요약이 뒤따름.
- 고양이 질문 > 고양이 관찰 기록이 1위.
- 산책 질문 > 장면 태그가 합류된 산책 영상들.
- 그리고 개인기 질문, 기록에 없는 것. 최고 점수 0.44로 낮게 깔렸습니다.
네 번째가 이번 스모크의 핵심입니다. 있는 것을 찾는 것은 임베딩의 기본기지만, 없는 것을 물었을 때 점수가 낮게 깔리는 분포여야 상담 봇이 임계값 하나로 관찰 기록이 없다고 답할 수 있습니다. 봇의 정직함은 화법에서 나오는 것이 아니라 이러한 분포에서 나옵니다. 아는 것과 모르는 것 사이에 점수 간격이 있어야 모른다는 것을 구현할 수 있게 됩니다.
테스트는 11개가 추가됐습니다. RAG는 파이프라인의 산출물을 읽기만 하는 별도 컴포넌트로 구축하였습니다.
다만 시리즈의 기준으로 보면 스모크는 스모크입니다. 검색 품질도 골든셋으로 채점하는 일이고, 질문과 정답 쌍을 손으로 만들어 bge-m3의 검색을 점수화하는 일은 아직 하지 않았습니다. 관찰 서술이 장면 단위라서 다견 영상의 무리 행동("여러 마리가 뒤엉켜 놀음")이 개체 귀속 없이 남는 것도 한계입니다.
맺음말
DB 하나를 설정하는 데 하루가 걸렸고, 규칙은 네 개였습니다.
- 출처를 고정합니다. 카드는 사람, L2는 관찰 원문, L1만 LLM — 저작 텍스트는 DB 밖.
- LLM의 문장은 검수를 통과해야 저장됩니다. 주장 분해 > 기록 대조 > 재작성 1회 > 드롭. e2e에서 실제로 두 건을 잡았습니다.
- 신뢰 경계는 DB 앞까지입니다. 재식별 미확정이면 인제스트 거부, 재인제스트는 멱등.
- "모른다"는 분포로 준비합니다. 무관 질문이 0.44로 깔리는 간격이 상담 봇 정직함의 재료입니다.
시리즈의 문장에 하나를 보탭니다. 골든셋으로 채점하고, 측정할 수 있는 것은 측정에게 맡기고, 구조의 주인을 하나로 세우고, 빠르게 만들 때조차 자부터 검증한다. 그리고 DB에 넣기 전에, 출처부터 고정한다.
다음 편은 이 저장소 위에 서는 상담 봇입니다. 검색된 기록을 어떤 화법으로 인용할지, 카드·요약·관찰 원문에 각각 다른 말투를 줄지, 그리고 점수가 임계 아래일 때 "모른다"를 어떻게 말하게 할지. 저장이 정직해졌으니, 이제 다음을 구현하면 됩니다.
이 글에서 다룬 고정 함수 분류층은 ProjectDavid의 일부입니다.
전체를 바닥부터 만드는 과정은 강의 3부작으로 정리하고 있고, 10월에 오픈 예정입니다.
→ 오픈 알림 받기
이전글
스레드보다 자원: Mac GPU(MPS)로 3.5배 빠르게 - Resource First AI
GitHub - chessire/shelter-puppyContribute to chessire/shelter-puppy development by creating an account on GitHub.github.com파이프라인을 빠르게 만드는 첫 질문은"스레드를 몇 개 띄울까?"가 아니라"어떤 자원이 어디서 놀고
chessire.tistory.com
관련글
오픈소스 LLM vs 빅테크 LLM API: AI 사업의 비용과 리스크
모델은 커모디티가 된다.마진은 판단에 남는다. 2025년 2월, OpenAI는 당시 가장 비싼 모델 GPT-4.5를 출시했습니다. 백만 토큰당 입력 75 달러, 출력 150 달러. 그리고 다섯 달이 지나기 전, API에서 제거
chessire.tistory.com
'AI > Pipeline' 카테고리의 다른 글
| 로컬 LLM으로 LLM 위키 만들기, 기능 9개를 1개로 줄인 이유 (0) | 2026.09.06 |
|---|---|
| 환각을 통제하는 로컬 AI 파이프라인 만들기 (0) | 2026.08.03 |
| 스레드보다 자원: Mac GPU(MPS)로 3.5배 빠르게 - Resource First AI (0) | 2026.07.27 |
| LLM은 지시만: 프롬프트 오염을 막는 설계 - Ownership First AI (0) | 2026.07.23 |
| 로컬 TTS(mlx-audio)로 영상 타임라인 컨트롤 - Narration First AI (0) | 2026.07.20 |